

⚠️免责提示:本文档由网友上传,本站仅做存储分享。如存在版权侵权问题,请联系客服举报,核实后立即下架。
📄文档内容总结
标准输出格式
主要内容:
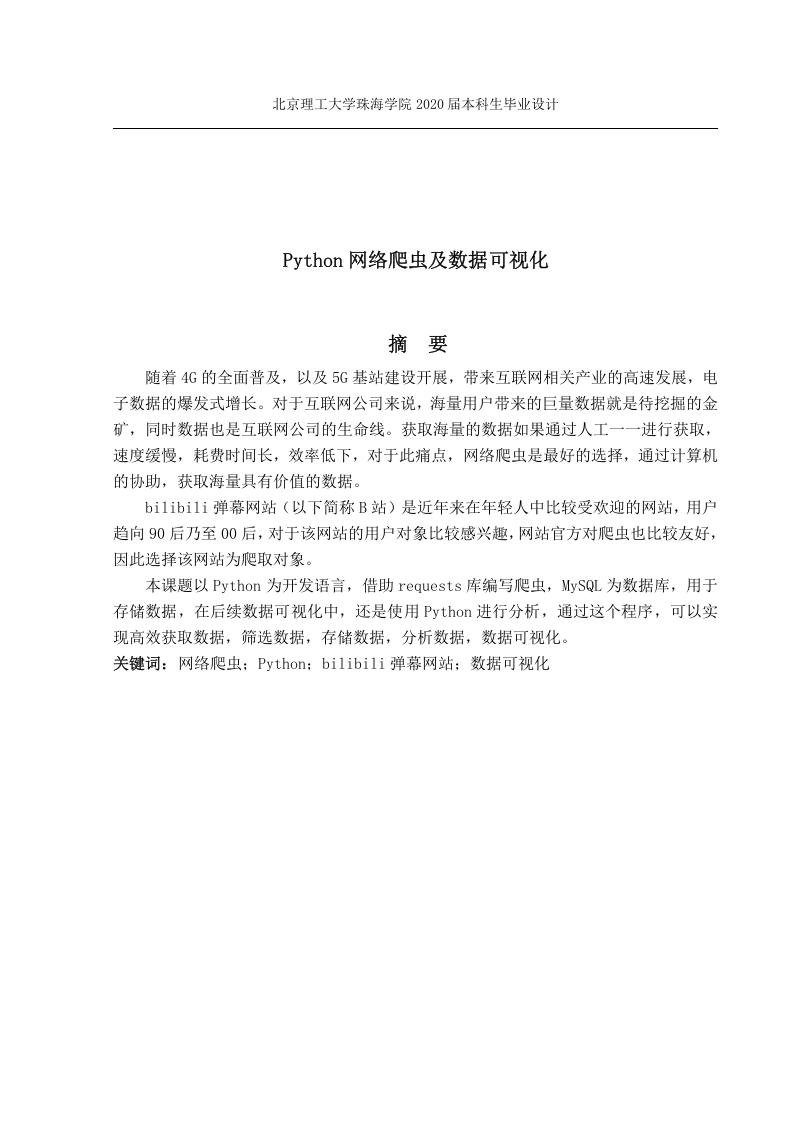
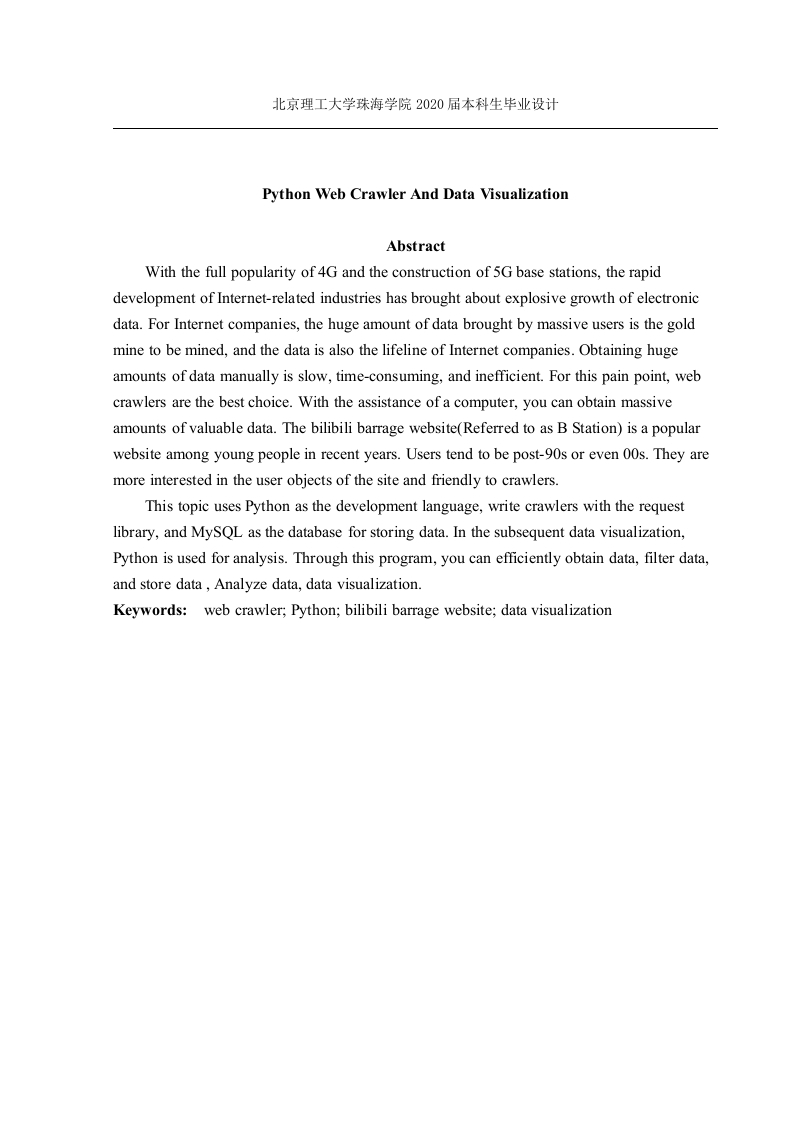
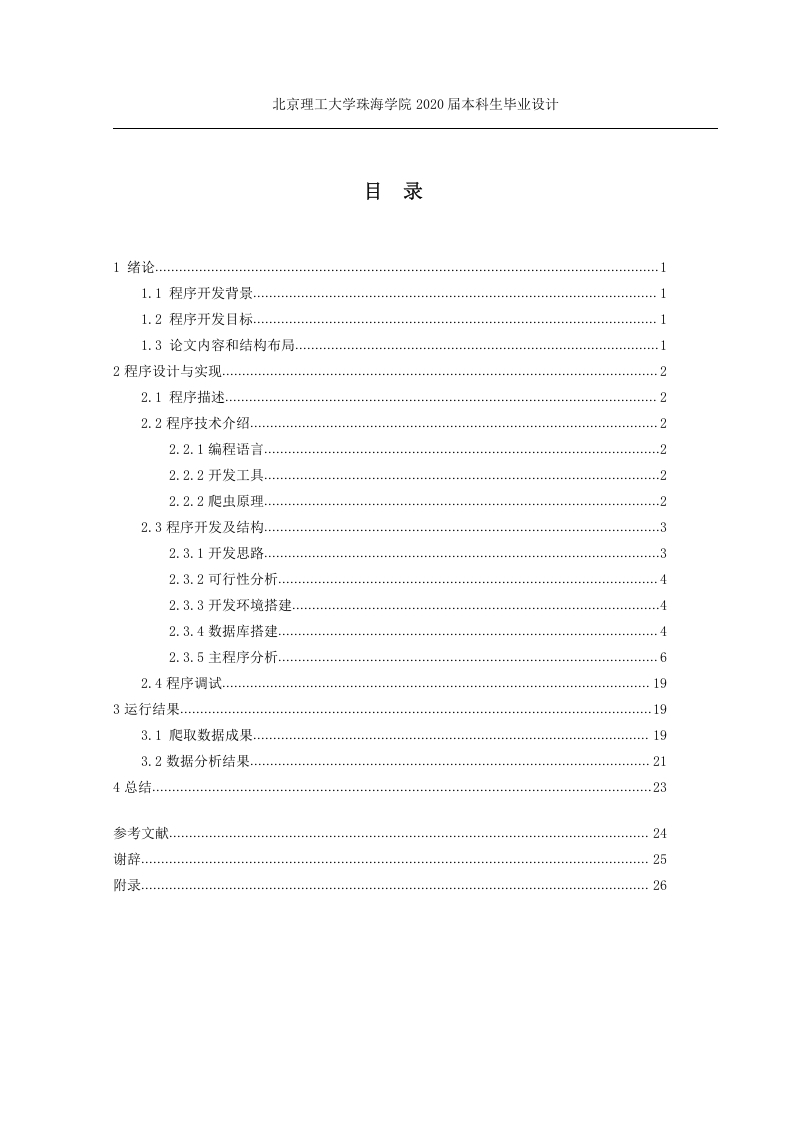
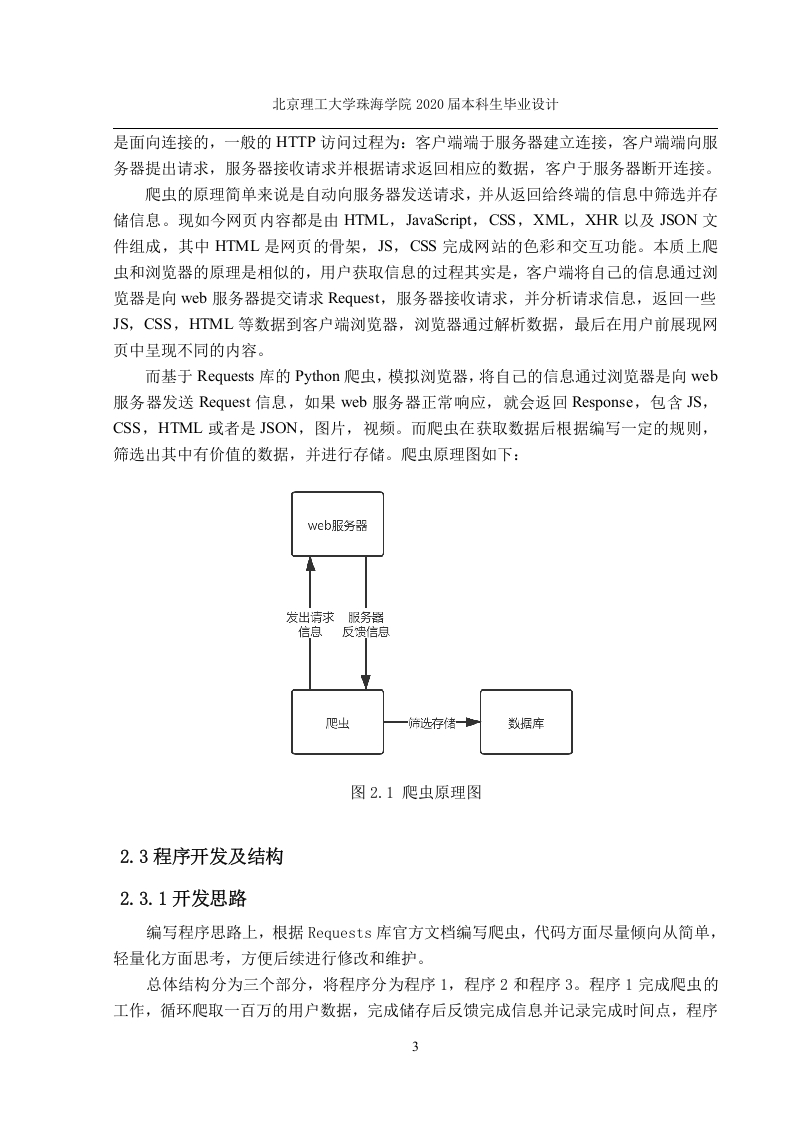
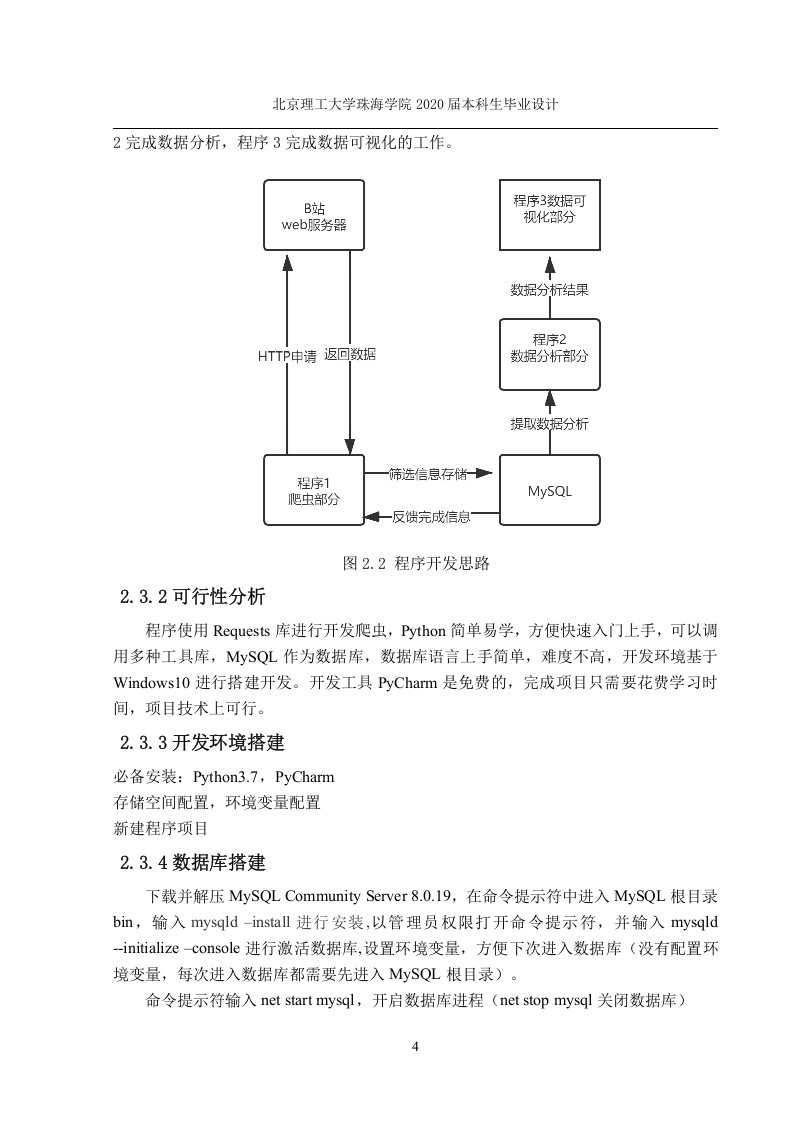
本篇文档详细介绍了Python网络爬虫及数据可视化的基本概念、常用工具、实践技巧以及应用案例。首先,文章概述了网络爬虫的基本原理和常见应用场景,包括数据采集、信息提取和数据清洗等关键步骤。接着,详细介绍了Python中常用的爬虫框架,如Scrapy、BeautifulSoup和Requests等,并提供了实际操作示例。此外,文档还探讨了数据可视化的重要性及其在数据分析中的应用,介绍了常用的可视化库,如Matplotlib、Seaborn和Plotly等,并通过具体案例展示了如何使用这些工具进行数据可视化。最后,文章总结了网络爬虫和数据可视化的最佳实践,包括遵守网站robots.txt协议、保护用户隐私和数据安全等注意事项。
文档类型:
技术指南
主要用途:
该文档可作为技术开发者和互联网运营人员的参考材料,帮助他们理解和掌握Python网络爬虫及数据可视化的相关知识和技能,从而提高数据采集和分析的效率。
核心价值:
文档提供了详细的Python网络爬虫和数据可视化操作指南,包括常用工具介绍、实践技巧分享和具体案例分析,具有较强的实用性和参考价值。
适用人群:
技术开发者、互联网运营人员、数据分析师等。
付费资源
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END
暂无评论内容